Contenido · 8 secciones
Cuando armé este sitio bloqueé a todos los bots que recorren la web para entrenar modelos de IA. Me pareció lo prudente: ¿por qué regalarle mi contenido a una empresa que lo usará para su producto? Unos meses después, escribiendo sobre cómo lograr que la IA recomiende a una empresa, me hice la pregunta al revés: si quiero que la IA me conozca, ¿por qué le estoy cerrando la puerta?
Terminé abriéndola. Pero no es una decisión que sirva para todos, así que aquí va lo que ganas, lo que pierdes y cómo decidirlo.
Dos tipos de bots, dos objetivos distintos
Las empresas de IA usan robots distintos para cosas distintas. La diferencia importa porque puedes permitir unos y bloquear otros:
| Bots de búsqueda | Bots de entrenamiento | |
|---|---|---|
| Ejemplos | OAI-SearchBot (ChatGPT), Claude-SearchBot, PerplexityBot | GPTBot (OpenAI), ClaudeBot (Anthropic), Google-Extended, CCBot |
| Para qué leen tu sitio | Para responder en el momento lo que alguien pregunta | Para entrenar el próximo modelo |
| Cómo te mencionan | Con enlace a tu página como fuente | Sin enlace: el modelo “sabe” de ti |
| Qué versión usan | La actual | Una foto de tu sitio de hace meses |
| Si los bloqueas | Desapareces de las respuestas con búsqueda | Tu contenido no entra en futuros entrenamientos |
Dos aclaraciones que suelen confundir. Bloquear GPTBot no te saca de las respuestas con búsqueda de ChatGPT, porque esas usan OAI-SearchBot (OpenAI, 2026). Y bloquear Google-Extended no afecta tu posicionamiento en Google: solo controla el uso de tu contenido en Gemini (Google Search Central, 2026).
Lo que dicen los datos
Cloudflare, que protege una parte importante de la web, publicó en 2025 un análisis del tráfico de bots de IA (Cloudflare, 2025):
- El 79 % del rastreo de IA es para entrenamiento, frente al 72 % un año antes. La búsqueda bajó del 26 % al 17 %.
- Rastrean mucho y devuelven poco. En julio de 2025, Anthropic rastreó unas 38.000 páginas por cada visita que envió a un sitio; OpenAI, unas 1.100; Perplexity, 195; y Google, 5,4.
Es decir: el entrenamiento casi no trae visitas. Lo que puede traer es otra cosa, que los modelos conozcan tu marca.
Y la industria se está moviendo hacia el control. Desde julio de 2025, Cloudflare pregunta a cada dominio nuevo si quiere permitir los rastreadores de IA y parte bloqueándolos (Cloudflare, 2025). En septiembre de 2025 lanzó además las Content Signals, una forma de declarar en el robots.txt si permites usar tu contenido para búsqueda, para respuestas de IA o para entrenamiento; en los más de 3,8 millones de dominios que usan su robots.txt administrado aplicó por defecto “búsqueda sí, entrenamiento no” (Cloudflare, 2025).
Lo que ganas y lo que pierdes
| Si los dejas entrar | Si los bloqueas | |
|---|---|---|
| Reconocimiento | Los modelos pueden conocer tu marca y mencionarla sin buscar | Los modelos dependen solo de la búsqueda para saber de ti |
| Visitas | Casi ninguna directa | Ninguna diferencia: el entrenamiento casi no envía visitas |
| Control | Ninguno: no se puede corregir ni retirar lo aprendido | Tu contenido queda fuera de futuros entrenamientos |
| Riesgo | Que otros obtengan gratis lo que tú vendes | Que la IA sepa menos de ti que de tu competencia |
| Carga del servidor | Más rastreo | Menos rastreo (si el bot respeta el robots.txt) |
Cómo decidir según tu negocio
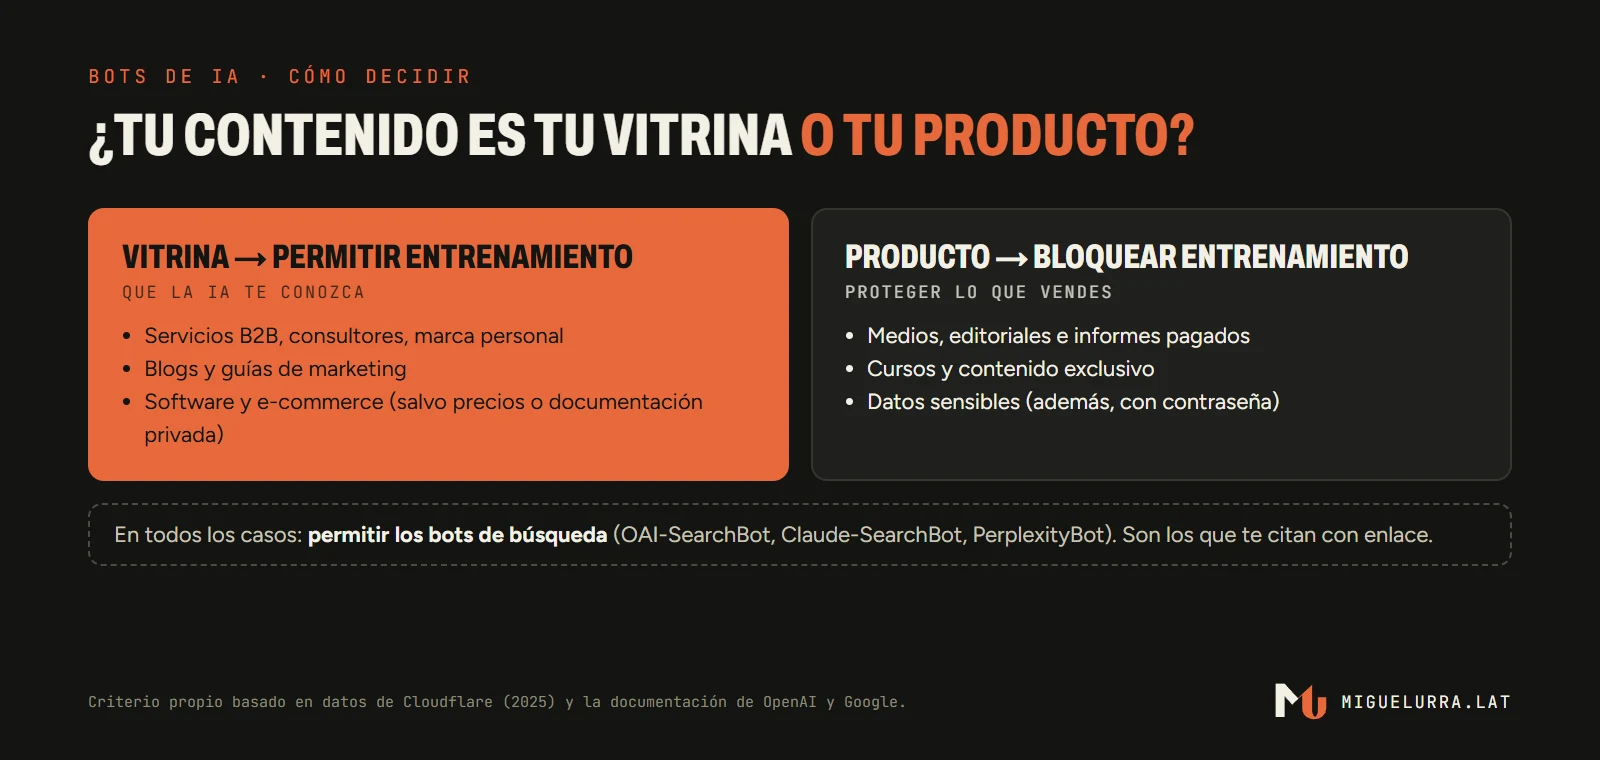
| Tu caso | Entrenamiento | Búsqueda |
|---|---|---|
| Empresa de servicios B2B, consultor, marca personal | Permitir: tu contenido existe para que te conozcan | Permitir |
| Software, e-commerce, empresa con blog de marketing | Permitir, salvo documentación o precios que no quieras difundir | Permitir |
| Medio de comunicación, editorial, cursos, informes pagados | Bloquear: el contenido es tu producto | Permitir, salvo que negocies acceso |
| Datos sensibles o áreas privadas | Bloquear (y protegerlas con contraseña, no solo con robots.txt) | Bloquear esas rutas |
En mi caso la respuesta fue simple: todo lo que publico existe para que me conozcan. Que un modelo sepa que existo, qué hago y cómo pienso es parte de eso. Lo único que mantengo cerrado para todos es la ruta interna de los formularios.
Cómo saber si tu sitio los está bloqueando
Antes de decidir, revisa cómo estás hoy. Hay tres formas, de la más rápida a la más completa:
- Con el verificador: hice una herramienta gratuita que lee tu robots.txt y te dice, robot por robot, cuáles de búsqueda y cuáles de entrenamiento pueden entrar. Pruébala en el verificador de bots de IA.
- A mano: abre
tusitio.com/robots.txten el navegador y busca los nombres de la tabla de arriba. Si un robot aparece conDisallow: /, está bloqueado. Si no aparece, se aplica la regla general (User-agent: *). - En tu proveedor: si tu sitio usa Cloudflare u otro servicio de seguridad, revisa su panel de bots. Puede bloquear a los robots de IA aunque tu robots.txt los permita, y eso no se ve desde afuera.
Cómo hacerlo en la práctica
- Parte por el diagnóstico de la sección anterior. Muchos sitios bloquean a todos los bots de IA con una plantilla copiada, sin distinguir búsqueda de entrenamiento.
- Separa por robot. Un ejemplo que permite la búsqueda y bloquea el entrenamiento:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Para permitir también el entrenamiento, cambia Disallow: / por Allow: / en los robots de entrenamiento.
- Revisa Cloudflare u otro servicio de seguridad. Si tu sitio está detrás de Cloudflare, en el panel puede haber un bloqueo de bots de IA activo que pasa por encima de lo que diga tu robots.txt. Revisa la sección de bots y el control de rastreadores de IA.
- Recuerda que el robots.txt es una declaración, no un candado. Los bots de las grandes empresas dicen respetarlo; para bloquear de verdad hay que hacerlo en el servidor.
- Revisa la decisión cada cierto tiempo. Este tema cambia rápido: nuevos robots, nuevas reglas y nuevos acuerdos entre sitios y empresas de IA.
La pregunta de fondo
Bloquear o permitir no es una decisión técnica: es una decisión de negocio. La pregunta no es “¿me están usando?”, sino “¿mi contenido es mi producto o es mi vitrina?”. Si es tu producto, protégelo. Si es tu vitrina, que la vea todo el mundo, incluidas las máquinas que hoy le responden a tu próximo cliente.
Si quieres revisar tu sitio ahora, el verificador de bots de IA lee tu robots.txt y te muestra qué robots dejas entrar.
Fuentes
- Cloudflare (2025). The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals. Datos de enero a julio de 2025.
- Cloudflare (2025). Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large. 1 de julio de 2025.
- Cloudflare (2025). Content Signals Policy. 24 de septiembre de 2025.
- OpenAI (2026). Overview of OpenAI crawlers.
- Google Search Central (2026). Google’s common crawlers: Google-Extended.
- #IA
- #GEO
- #robots.txt
- #Cloudflare
- #Bots de IA